ANALIZA STATYSTYCZNA W PRAKTYCE
Jak sprawdzić, czy pytania ankiety rzeczywiście mierzą zakładane obszary?
Umieszczenie kilku pytań pod wspólnym nagłówkiem nie dowodzi, że tworzą one jedną skalę. Konfirmacyjna analiza czynnikowa pozwala sprawdzić, czy zależności obserwowane w danych są zgodne z wcześniej określonym modelem: które pozycje mają mierzyć dany obszar, ile obszarów obejmuje narzędzie i w jaki sposób są one ze sobą powiązane.
W wielu badaniach ankietowych autor przypisuje pytania do obszarów już na etapie konstruowania kwestionariusza. Kilka stwierdzeń ma opisywać wsparcie informacyjne, kolejne wsparcie emocjonalne, a następne organizację opieki. Taki podział jest hipotezą dotyczącą budowy narzędzia, a nie wynikiem analizy.
Jeżeli później oblicza się średnią dla każdego obszaru, zakłada się, że przypisane do niego pozycje są przejawami wspólnego konstruktu. CFA pozwala tę strukturę poddać weryfikacji. Nie służy przy tym do automatycznego poprawiania kwestionariusza ani do wyszukiwania dowolnego modelu, który najlepiej pasuje do jednej próby. Jej sens polega na sprawdzeniu jasno sformułowanych założeń pomiarowych.
Jaki problem rozwiązuje CFA?
Część zjawisk badanych za pomocą ankiet nie jest obserwowalna bezpośrednio. Satysfakcji, poczucia bezpieczeństwa, wypalenia zawodowego czy wsparcia społecznego nie mierzy się tak jak wieku lub czasu trwania hospitalizacji. O ich poziomie wnioskuje się na podstawie odpowiedzi na kilka pytań nazywanych pozycjami lub wskaźnikami obserwowalnymi.
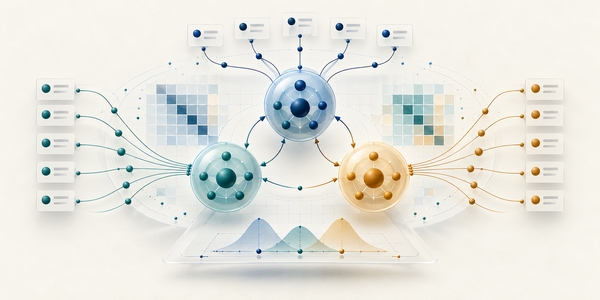
Konstrukt, którego nie obserwujemy bezpośrednio, jest w modelu czynnikiem latentnym. Jeżeli cztery pytania mają mierzyć wsparcie informacyjne, model zakłada, że wspólny czynnik wyjaśnia część ich współzmienności. Każda pozycja zawiera jednocześnie składnik swoisty oraz błąd pomiaru, dlatego nie oczekuje się, że będzie idealnym odbiciem konstruktu.
CFA odpowiada zatem na pytanie, czy określony wcześniej układ powiązań między pozycjami i czynnikami jest możliwy do pogodzenia z danymi. Pozwala również porównać konkurencyjne modele, na przykład jeden ogólny czynnik z modelem obejmującym trzy powiązane, lecz odrębne wymiary.
Najważniejsza zasada
CFA weryfikuje model pomiarowy wynikający z teorii, konstrukcji narzędzia lub wcześniejszych badań. Nie nadaje znaczenia czynnikom bez udziału argumentacji merytorycznej.
CFA a eksploracyjna analiza czynnikowa
Eksploracyjna analiza czynnikowa i CFA dotyczą struktury zależności między pozycjami, ale odpowiadają na inne pytania. W podejściu eksploracyjnym badacz poszukuje możliwej liczby czynników i układu ładunków. Pozycje mogą wiązać się z kilkoma wymiarami, a struktura wyłania się przede wszystkim z danych.
W CFA model jest określony przed estymacją. Badacz wskazuje liczbę czynników, przypisuje do nich pozycje, ustala dopuszczalne korelacje oraz określa, które parametry mają pozostać równe zeru. Analiza sprawdza następnie, jak dobrze ten konkretny układ odtwarza obserwowane zależności.
Jeżeli narzędzie jest całkowicie nowe, a jego struktura nie została wcześniej dobrze uzasadniona, rozpoczęcie od CFA może być przedwczesne. Rozsądniejsze bywa przeprowadzenie analizy eksploracyjnej w jednej próbie, a następnie potwierdzenie uzyskanego modelu w niezależnych danych. Testowanie i potwierdzanie struktury na tych samych osobach zwiększa ryzyko dopasowania modelu do przypadkowych właściwości próby.
Od teorii do modelu pomiarowego
Model CFA powinien powstać przed oceną wyników dopasowania. Punktem wyjścia jest definicja każdego konstruktu oraz uzasadnienie, dlaczego dana pozycja ma stanowić jego przejaw. Potrzebna jest również decyzja, czy obszary mają być odrębne, skorelowane, podporządkowane czynnikowi wyższego rzędu czy ujęte w innym modelu teoretycznym.
- każda pozycja zostaje przypisana do określonego czynnika;
- ustala się, czy czynniki mogą być ze sobą skorelowane;
- określa się, które ładunki i korelacje błędów mają pozostać równe zeru;
- zapewnia się identyfikowalność modelu, aby jego parametry mogły zostać oszacowane;
- sprawdza się zgodność kierunku punktacji i znaczenia wszystkich pozycji;
- ustala się sposób traktowania braków danych oraz charakter skali odpowiedzi.
Szczególnej ostrożności wymagają modele, w których czynnik reprezentuje bardzo szeroki obszar, a pozycje dotyczą niejednorodnych treści. Nawet jeśli wszystkie pytania są związane z tym samym ogólnym tematem, nie muszą być wymiennymi przejawami jednego konstruktu. Model powinien odzwierciedlać sposób działania pomiaru, a nie jedynie układ kwestionariusza na papierze.
Nie każda grupa pytań powinna tworzyć czynnik
Klasyczna CFA jest szczególnie naturalna dla modeli refleksyjnych. Zakłada się w nich, że konstrukt wpływa na odpowiedzi na pozycje. Wyższe nasilenie lęku może na przykład zwiększać prawdopodobieństwo występowania różnych objawów, dlatego odpowiedzi współzmieniają się jako przejawy wspólnego zjawiska.
Inaczej wygląda sytuacja, gdy elementy składają się na wynik, ale nie muszą być wzajemnie podobne. Liczba chorób, liczba przyjmowanych leków i trudności finansowe mogą wspólnie opisywać obciążenie, lecz nie są zamiennymi przejawami jednego ukrytego czynnika. Taki wskaźnik ma raczej charakter kompozytowy lub formatywny. Niska korelacja między jego składnikami nie musi świadczyć o wadzie, a klasyczna CFA może nie być właściwym narzędziem oceny.
Ważne rozróżnienie
Zbiór pytań może mieć wspólną nazwę i tworzyć użyteczny indeks, nie będąc jednocześnie jednowymiarową skalą refleksyjną.
Dane porządkowe wymagają odpowiedniej estymacji
Pozycje ankietowe często wykorzystują skale Likerta z kilkoma uporządkowanymi kategoriami. Takie odpowiedzi nie są zmiennymi ciągłymi w ścisłym znaczeniu. Przy małej liczbie kategorii, silnej asymetrii lub rzadkich odpowiedziach skrajnych zastosowanie zwykłej metody największej wiarygodności może prowadzić do zniekształconych błędów standardowych i wskaźników dopasowania.
W analizie pozycji porządkowych często stosuje się estymatory wykorzystujące korelacje polichoryczne, na przykład WLSMV lub rozwiązania o zbliżonych właściwościach. Dla zmiennych traktowanych jako ciągłe można wykorzystywać estymację największej wiarygodności, w razie potrzeby w wariancie odpornym na naruszenie normalności. Wybór nie powinien wynikać z przyzwyczajenia do programu, lecz z poziomu pomiaru, rozkładów odpowiedzi, liczebności i braków danych.
Znaczenie ma także macierz analizowana przez model oraz sposób obsługi niepełnych obserwacji. Dwa programy mogą zwrócić nieco odmienne wyniki nie dlatego, że jeden z nich działa błędnie, lecz dlatego, że zastosowano inne estymatory, korekty lub zasady postępowania z brakami. Metodę estymacji należy więc jawnie podać w raporcie.
Jak ocenia się dopasowanie modelu?
Nie istnieje jeden wskaźnik, który samodzielnie rozstrzyga o poprawności modelu. Ocena powinna łączyć kilka miar dopasowania, parametry modelu, diagnostykę lokalną oraz sens teoretyczny. Wartości graniczne spotykane w literaturze są wskazówkami, a nie uniwersalnymi progami zaliczenia. Ich zachowanie zależy między innymi od liczebności próby, złożoności modelu, wielkości ładunków i rodzaju danych.
| Miara | Co ocenia? | Jak ją interpretować? |
|---|---|---|
| χ² modelu | Dokładne odtworzenie macierzy zależności | Wynik nieistotny wspiera ścisłe dopasowanie, lecz test jest wrażliwy na liczebność próby i nawet małe rozbieżności. |
| CFI | Poprawę względem modelu bazowego | Wyższa wartość oznacza lepsze dopasowanie; nie powinna być oceniana w oderwaniu od pozostałych wyników. |
| TLI | Dopasowanie z uwzględnieniem złożoności | Wyższa wartość jest korzystna, a miara silniej uwzględnia oszczędność modelu. |
| RMSEA | Przybliżony błąd dopasowania w populacji | Niższa wartość jest korzystna; należy uwzględniać przedział ufności i właściwości modelu. |
| SRMR | Przeciętną wielkość standaryzowanych reszt | Niższa wartość wskazuje, że model dokładniej odtwarza obserwowane zależności. |
Możliwa jest sytuacja, w której część wskaźników wygląda korzystnie, a inne sygnalizują problem. Nie powinno się wówczas wybierać wyłącznie tych wartości, które pozwalają uznać model za dobry. Potrzebna jest łączna ocena: gdzie model nie odtwarza danych, czy parametry są sensowne oraz czy rozbieżność ma znaczenie dla interpretacji skali.
Ładunki czynnikowe pokazują związek pozycji z konstruktem
Ładunek czynnikowy opisuje, jak silnie dana pozycja jest związana z przypisanym czynnikiem. W wersji standaryzowanej ułatwia porównywanie pozycji mierzonych na tej samej lub różnych skalach. Wyższy ładunek oznacza, że odpowiedź w większym stopniu odzwierciedla wspólny konstrukt, ale nie stanowi automatycznie dowodu wysokiej jakości treściowej pytania.
Bardzo niski ładunek może wskazywać, że pozycja słabo reprezentuje czynnik, jest niejednoznaczna, ma ograniczoną zmienność albo odnosi się do innego aspektu. Nie należy jednak usuwać jej wyłącznie na podstawie jednej liczby. Pytanie może obejmować ważną część definicji konstruktu, której nie zastępują pozostałe pozycje.
Znaczenie mają również wariancje błędu, korelacje czynników i ewentualne nieprawidłowości parametrów. Korelacja czynników bliska jedności może sugerować, że teoretycznie odrębne wymiary są w danych trudno rozróżnialne. Ujemna wariancja błędu, współczynnik poza dopuszczalnym zakresem lub brak zbieżności estymacji wymagają diagnozy, a nie mechanicznej interpretacji pozostałych wyników.
Reszty i indeksy modyfikacji
Globalne wskaźniki informują, czy model jako całość odtwarza dane, lecz nie wskazują dokładnie źródła problemu. Standaryzowane reszty pomagają zidentyfikować pary pozycji, dla których zależność przewidywana przez model wyraźnie odbiega od zależności obserwowanej.
Indeksy modyfikacji szacują, jak mogłoby zmienić się dopasowanie po uwolnieniu określonego parametru, na przykład dodatkowego ładunku lub korelacji błędów. Są narzędziem diagnostycznym, a nie listą automatycznych zaleceń. Dodawanie kolejnych korelacji tylko dlatego, że poprawiają CFI lub RMSEA, prowadzi do modelu dopasowanego do konkretnej próby, który może nie odtworzyć się w nowych danych.
Korelacja błędów może być uzasadniona, gdy dwie pozycje mają bardzo podobne brzmienie, wspólny kontekst, tę samą metodę pomiaru lub dodatkową treść niewyjaśnianą przez czynnik. Każda taka decyzja powinna mieć podstawę merytoryczną, zostać opisana i najlepiej poddana weryfikacji w niezależnej próbie.
Częsty błąd
Model nie staje się teoretycznie poprawny tylko dlatego, że po serii modyfikacji osiągnął oczekiwane wartości wskaźników dopasowania.
Co zrobić, gdy model nie pasuje?
Słabe dopasowanie nie oznacza automatycznie, że należy usuwać pytania. Najpierw trzeba ustalić możliwe źródło rozbieżności. Problem może dotyczyć błędnego przypisania pozycji, zbyt małej liczby czynników, niejednorodnej treści, odwróconego sformułowania, efektu metody, rozkładów odpowiedzi albo niedostosowanej metody estymacji.
- Sprawdź dane i kodowanie. Błędnie odwrócona pozycja, rzadka kategoria lub duża liczba braków może zaburzyć cały model.
- Wróć do treści pytań. Należy ocenić, czy pozycje rzeczywiście odpowiadają definicji czynnika i są jednoznaczne.
- Zbadaj diagnostykę lokalną. Reszty, ładunki i indeksy modyfikacji pomagają wskazać miejsce niedopasowania.
- Rozważ model konkurencyjny. Alternatywa powinna wynikać z teorii, a nie wyłącznie z dążenia do lepszych statystyk.
- Oceń konsekwencje zmiany. Usunięcie pozycji może poprawić dopasowanie, lecz zawęzić znaczenie konstruktu.
- Potwierdź zmodyfikowany model. Najbardziej wiarygodna weryfikacja wymaga nowych danych lub odpowiedniego podziału próby.
Czy istnieje minimalna liczebność próby?
Nie ma jednej liczby uczestników, która gwarantuje poprawną CFA w każdym badaniu. Potrzebna liczebność zależy od liczby czynników i pozycji, wielkości ładunków, rozkładów odpowiedzi, braków danych, siły korelacji między czynnikami, metody estymacji oraz stopnia złożoności modelu.
Proste reguły w rodzaju określonej liczby osób na jedną pozycję mogą pełnić funkcję bardzo wstępnej orientacji, lecz nie zastępują oceny konkretnego modelu. Dwie analizy o tej samej liczbie pytań mogą mieć zupełnie inne wymagania. Model z silnymi, stabilnymi ładunkami i dobrze reprezentowanymi czynnikami jest łatwiejszy do oszacowania niż model z licznymi słabymi pozycjami, rzadkimi kategoriami i wysokimi korelacjami wymiarów.
Przy planowaniu badania warto wykorzystywać symulacje lub analizy mocy dostosowane do zakładanego modelu. Po zebraniu danych należy natomiast zwrócić uwagę na stabilność oszacowań, błędy standardowe, zbieżność algorytmu i ewentualne problemy identyfikacyjne. Sama duża próba nie naprawia błędnie określonego modelu.
Czego CFA nie potwierdza?
Dobre dopasowanie oznacza, że dane nie przeczą w wyraźny sposób zakładanemu modelowi, ale nie dowodzi, że jest on jedynym możliwym wyjaśnieniem. Inny model może odtwarzać dane równie dobrze lub lepiej. CFA nie potwierdza również przyczynowego wpływu konstruktu na zachowanie ani nie zastępuje oceny jakości treści pytań.
- dobre dopasowanie nie jest dowodem rzetelności wyniku;
- wysokie ładunki nie potwierdzają samodzielnie trafności konstruktu;
- model jednowymiarowy nie gwarantuje, że suma punktów ma użyteczną interpretację;
- odrębne czynniki w modelu nie muszą być wystarczająco różne w sensie trafności różnicowej;
- struktura potwierdzona w całej próbie nie musi działać tak samo w różnych grupach;
- wynik uzyskany po licznych modyfikacjach wymaga niezależnego potwierdzenia.
CFA jest zatem ważnym etapem walidacji, ale nie jej końcem. Po ocenie struktury należy zbadać rzetelność, trafność zbieżną i różnicową, związki z innymi zmiennymi oraz — jeśli planowane są porównania grup — niezmienniczość pomiaru.
Jak raportować konfirmacyjną analizę czynnikową?
Opis analizy powinien umożliwić odtworzenie najważniejszych decyzji. Samo zdanie, że model uzyskał dobre dopasowanie, nie wyjaśnia, jaki model testowano, jak potraktowano dane ani czy wprowadzono modyfikacje.
- podstawa teoretyczna i liczba testowanych czynników;
- liczba pozycji przypisanych do każdego czynnika;
- charakter danych i zastosowany estymator;
- sposób postępowania z brakami danych;
- statystyka χ² wraz ze stopniami swobody i wartością p;
- CFI, TLI, RMSEA z przedziałem ufności oraz SRMR;
- zakres standaryzowanych ładunków czynnikowych i informacje o problematycznych parametrach;
- wszystkie modyfikacje modelu wraz z ich uzasadnieniem;
- porównanie modeli konkurencyjnych, jeśli było częścią planu analizy.
Diagram ścieżkowy może ułatwić odbiór wyników, ale nie powinien zastępować tabeli i opisu. Należy jasno rozróżnić model zaplanowany przed analizą od wersji zmodyfikowanej na podstawie danych. Dzięki temu czytelnik może ocenić, czy rezultat ma charakter potwierdzający, czy częściowo eksploracyjny.
Praktyczny schemat analizy
- Zdefiniuj konstrukty. Określ ich zakres treściowy i relacje z innymi wymiarami.
- Zapisz model przed analizą. Przypisz pozycje do czynników i ustal dopuszczalne zależności.
- Sprawdź dane. Zweryfikuj kodowanie, rozkłady, rzadkie kategorie, braki i pozycje odwrócone.
- Dobierz estymator. Uwzględnij porządkowy lub ciągły charakter zmiennych oraz naruszenia założeń.
- Oceń dopasowanie globalne. Interpretuj kilka wskaźników łącznie, bez mechanicznego stosowania progów.
- Oceń parametry i diagnostykę lokalną. Sprawdź ładunki, korelacje czynników, reszty i nieprawidłowe oszacowania.
- Wprowadzaj tylko uzasadnione zmiany. Każda modyfikacja powinna mieć sens teoretyczny i zostać ujawniona.
- Zweryfikuj model ponownie. Jeśli struktura została zmieniona na podstawie danych, potrzebne jest niezależne potwierdzenie.
- Dopiero potem twórz wskaźniki. Sposób obliczania wyników powinien odpowiadać potwierdzonej strukturze narzędzia.
Najczęstsze błędy w praktyce
- wykonywanie CFA bez jasno określonego wcześniej modelu;
- traktowanie nazw bloków ankiety jako wystarczającego uzasadnienia czynników;
- stosowanie estymatora niedostosowanego do porządkowych i silnie asymetrycznych odpowiedzi;
- uznawanie modelu za dobry na podstawie pojedynczego wskaźnika dopasowania;
- mechaniczne stosowanie progów bez uwzględnienia właściwości modelu i danych;
- usuwanie pozycji wyłącznie dlatego, że mają niższe ładunki;
- dodawanie wielu korelacji błędów na podstawie indeksów modyfikacji bez uzasadnienia;
- pomijanie informacji o zmianach wprowadzonych po obejrzeniu wyników;
- uznawanie dobrego dopasowania za pełny dowód rzetelności i trafności skali;
- potwierdzanie modelu w tych samych danych, które posłużyły do jego odkrycia i modyfikacji.
Podsumowanie
Konfirmacyjna analiza czynnikowa pozwala sprawdzić, czy odpowiedzi na pytania są zgodne z zakładaną strukturą pomiarową. Łączy założenia teoretyczne z empiryczną oceną dopasowania, ładunków, błędów i relacji między czynnikami.
Wartość CFA nie polega na uzyskaniu kilku statystyk mieszczących się w przyjętych progach. Najważniejsze jest to, czy model został określony przed analizą, czy zastosowana metoda odpowiada danym, czy parametry mają sens oraz czy ewentualne zmiany nie pozbawiły konstruktu jego znaczenia.
Dopiero model, który jest jednocześnie poprawny statystycznie, spójny teoretycznie i możliwy do odtworzenia w nowych danych, stanowi mocną podstawę do tworzenia i interpretowania wskaźników syntetycznych.
W kolejnej części serii
Jak sprawdzić, czy wskaźnik syntetyczny jest rzetelny i trafny — dlaczego sama alfa Cronbacha nie wystarcza i jakie informacje wnoszą omega McDonalda, AVE oraz HTMT?